聚是一團火,散是滿天星。
剛剛,前
DeepSeek
V1作者、
DeepSeek
-VL項目負責人Tony Zhang(張博),正式公布了自己的新創業項目:Linger。
方向,正是當下最火的個人Personal Agent。
路線也是比較有意思,當同行都在做APP,他們優先選擇了電腦。
這意味著,Linger能操縱你電腦已有的網頁、郵件箱、日曆,無需折騰一大堆登錄憑據。
遇到卡住的地方,你也可以直接上手接管。
另外一個點,作為中間層的Linger,支持接入各個第三方模型。
並且專門為本地LLM做了優化。
具體來說,一塊12GB顯存的RTX 3060顯卡,就能跑起一個125B參數的Qwen3.8-Flash-Next,並且是45.5 tokens/秒的生成速度。
對了,還有個蠻重要的事情——
這套系統是開源的。。。
至於為什麼?
在官宣帖中,Tony Zhang引用了PC崛起的歷史:
1960年代,計算是中心化的,直到PC將權力交到每個人手中。如今,AI在數據中心訓練,然後以token的形式租給你。
我們相信智能應該是分佈式的。你的上下文、你的數據,以及驅動它們的智能,都應該完全由你擁有。
所以今天,他們開源了Linger,一個生活在你個人電腦上的專屬Agent。
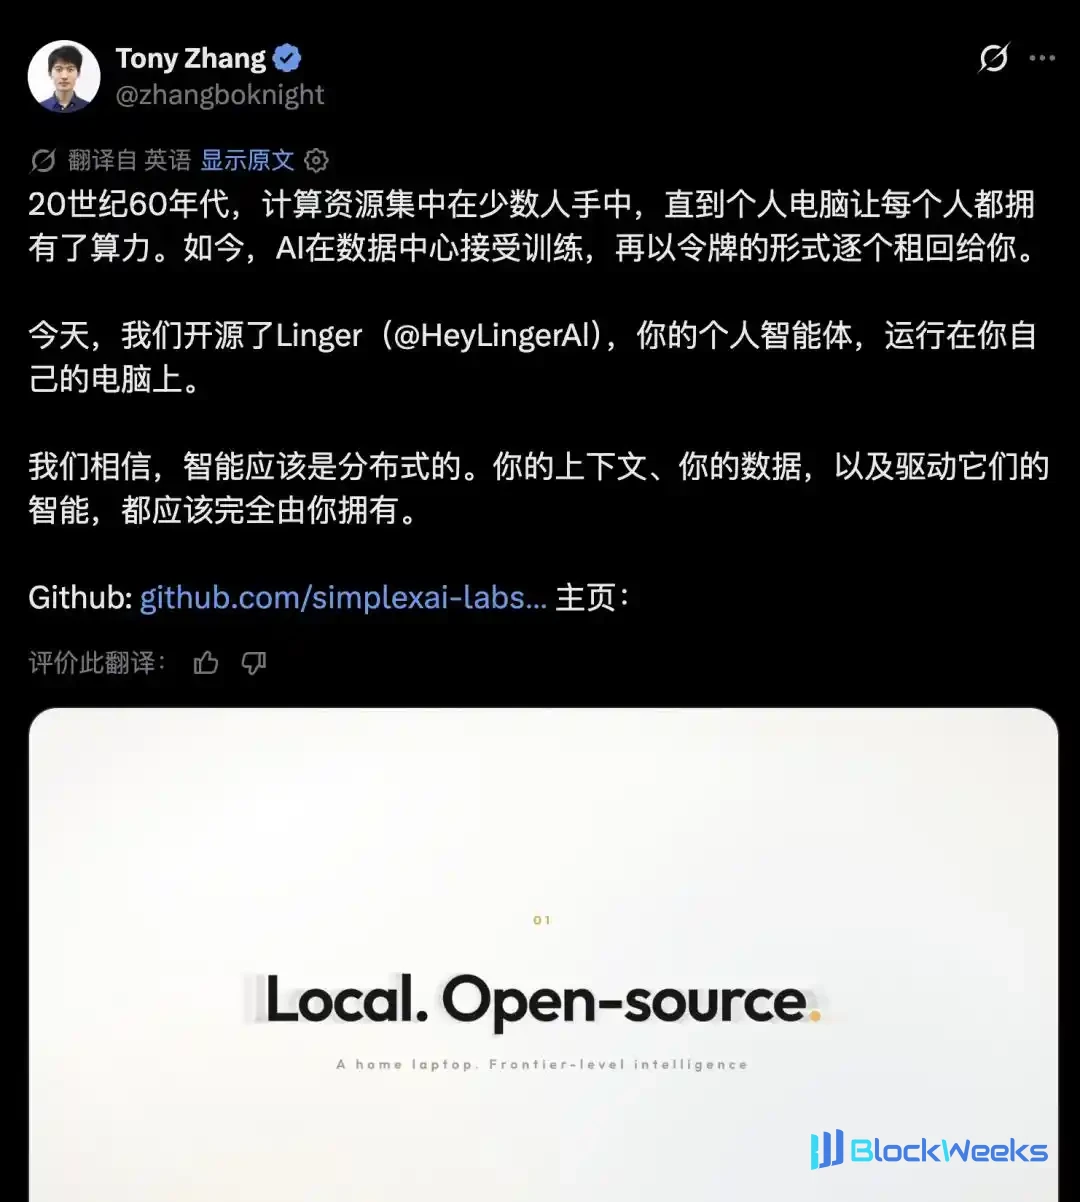
也是延續大肥鯨優良傳統了😭。
一個「會主動,能自學」的AI
Linger的的核心,是名為「Another Me」的Agent系統。
它首先是一個記憶中樞。
Linger會在本地讀取你的收件箱、日曆、聊天記錄和會議,每晚自動將這些信息整理成個人知識庫(Wiki),供所有Agent查詢。
在衡量長期對話記憶能力的LoCoMo基準測試中,Linger的準確率達到了95%,超過了Mem0、MemOS等多個記憶增強型AI系統。

有了這些,Linger便能更好地主動工作。
它會默默觀察你的信息流,根據事件的重要性和緊急性決定何時提醒你。週一收到客戶郵件,要求週五前給報價,它不會立刻打擾,而是等到週三早上再彈出提醒。
但如果是會議時間變更,它會立即通知。

這個Agent還會從你的反饋中自我學習,Linger稱之為「隱式強化」。
比如,當它提醒你一張發票快到期了,你回覆說「上週就收到了,應該當時就告訴我」。系統會記下一個線索。
如果下一次另一張發票出現類似情況,你再次表達了相同的偏好,系統就會自動生成一條規則:「供應商發票→立即提醒」。

反之,如果你連續兩次對「快遞提醒」表現出不感興趣(比如直接忽略或回覆「不用告訴我」),它也會學會以後保持沉默。
你也可以直接下指令,一次性教會它。比如告訴它:「客戶的回覆,要立刻通知我」,或者「晚上9點後,會議變更這種事不用馬上說」。
這種持續的互動和學習,讓Agent越來越懂你的工作習慣,成為一個真正個人化的助理。
除此之外,Linger還能:
操作桌面和瀏覽器。
就是開頭說的,Linger能直接使用你電腦上已經登入的Chrome、各種App,無需重新配置。
組建Agent團隊。
這點就是
DeepSeek
之前解釋過的Super Agent原理了。
你下達一個複雜任務時,Another Me會調用或創建不同職能的Agent,協同完成工作。
而你,只用停留在和Linger的這一個Session。
語音互動。
這點主要就是服務於辦公場景了。
Linger能即時轉錄會議,會後直接向Agent提問會議內容,並讓它跟進待辦事項。
總而言之呢,就是一個專為辦公場景優化的Personal Agent。
不過,也有網友對這一產品定位不太理解:
為什麼不基於DeepSeek harness開發🤣跟ds-bot有何區別呢
對此,Tony Zhang回應道:
Linger的重點是把模型和harness一起優化:12GB顯卡就能本地跑125B模型,不按token付費,數據也不出本機。
從產品定位上看:DS-Bot的核心是Bot與Bot、Bot與群組的協作;Linger的核心是人與自己的Agent、Agent與本地環境。

12GB顯卡,跑125B模型
讓消費級硬體運行千億大模型,Linger的核心技術是一個名為PolyStrata的MoE推理引擎。
它的原理可以理解為一種智慧分層儲存機制。
對於一個龐大的MoE(專家混合)模型,PolyStrata會把最常用、最活躍的「專家模組」放在最快的GPU顯存裡,將不那麼常用的放在記憶體中,而使用頻率最低的則放在SSD固態硬碟上。
當模型需要調用某個專家時,系統會動態地在GPU、記憶體和SSD之間移動數據。這樣一來,就不需要把整個幾十上百GB的模型全部塞進有限的顯存裡。
效果立竿見影。
根據官方數據,一個125B參數的Qwen3.8-Flash-Next模型,在一台配備12GB RTX 3060和64GB記憶體的電腦上,可以實現45.5 tokens/秒的生成速度。
在更強的RTX 5090(32GB)上,速度則飆升至179 tokens/秒。
為了讓用戶更方便地用上本地大模型,Linger還做了一個「模型自動駕駛(Model Autopilot)」功能。
它會自動檢測你的硬體配置(GPU、顯存、記憶體),然後從49個語言模型、兩種推理引擎、多種量化方案和不同上下文長度的組合中,為你推薦並安裝性能最強的模型。

根據SimplexAI的評分體系,不同配置的本地設備可以獲得媲美主流雲端大模型的能力:
8GB顯卡+32GB記憶體:得分35.4,約等於Gemini 2.5 Pro。
Mac 24GB統一記憶體:得分51.9,約等於Claude Opus 4.5。
12GB顯卡+32GB記憶體:得分57.3,約等於Claude Opus 4.6。
這意味著,你的遊戲本或MacBook,將擁有一個真正強大的、7×24小時待命、沒有token費用、並且數據完全不出本地的AI大腦。
DeepSeek-VL負責人再創業
Linger背後,是一支有著深厚技術背景的團隊,其創始人Tony Zhang的履歷尤為亮眼。
(畢竟是
DeepSeek
系嘛…)

Tony Zhang本科畢業於浙江大學,2019年在香港科技大學取得博士學位,隨後加入微軟亞洲研究院(MSRA),長期從事電腦視覺和生成模型研究,是VQ-Diffusion、Rodin 3D數位人等多個知名專案的作者。
2023年,他加入
DeepSeek
,擔任AI科學家。
在這裡,他不僅參與了早期語言模型
DeepSeek
LLM V1系列的研發,更是視覺語言大模型
DeepSeek
-VL的專案負責人(Project Lead)。這款模型在真實世界場景下的圖像、文件、圖表理解能力備受好評。
離開
DeepSeek
後,Tony Zhang進入浙江大學任教,擔任百人計畫研究員、博士生導師,並創立了Simplex AI。
Linger就是Simplex AI的最新作品。

而作為Linger技術核心,那個專為本地部署而生的推理引擎?
據Tony Zhang透露,由團隊裡一位18歲的天才少年構建。
18歲?高中剛畢業?
本文來自微信公眾號「量子位」,作者:Jay