Rassemblés, nous sommes un feu ; dispersés, nous sommes des étoiles dans le ciel.
À l'instant, l'auteur de
DeepSeek
V1 et le chef de projet de
DeepSeek
-VL, Tony Zhang (Zhang Bo), a officiellement annoncé son nouveau projet de startup : Linger.
La direction est exactement ce qui est le plus en vogue en ce moment : l'Agent Personnel.
L'approche est également assez intéressante. Alors que ses pairs créent tous des applications, ils ont d'abord choisi l'ordinateur.
Cela signifie que Linger peut opérer les pages web, la boîte de réception et le calendrier déjà présents sur votre ordinateur, sans la complication d'une multitude d'identifiants de connexion.
Lorsqu'il se bloque quelque part, vous pouvez également prendre le relais directement.
Autre point : en tant que couche intermédiaire, Linger prend en charge la connexion à divers modèles tiers.
Et il a été spécifiquement optimisé pour les LLM locaux.
Concrètement, une seule carte graphique RTX 3060 avec 12 Go de VRAM peut exécuter un Qwen3.8-Flash-Next de 125 milliards de paramètres, à une vitesse de génération de 45,5 tokens/seconde.
Ah oui, il y a aussi quelque chose d'assez important—
Ce système est open source...
Quant à savoir pourquoi ?
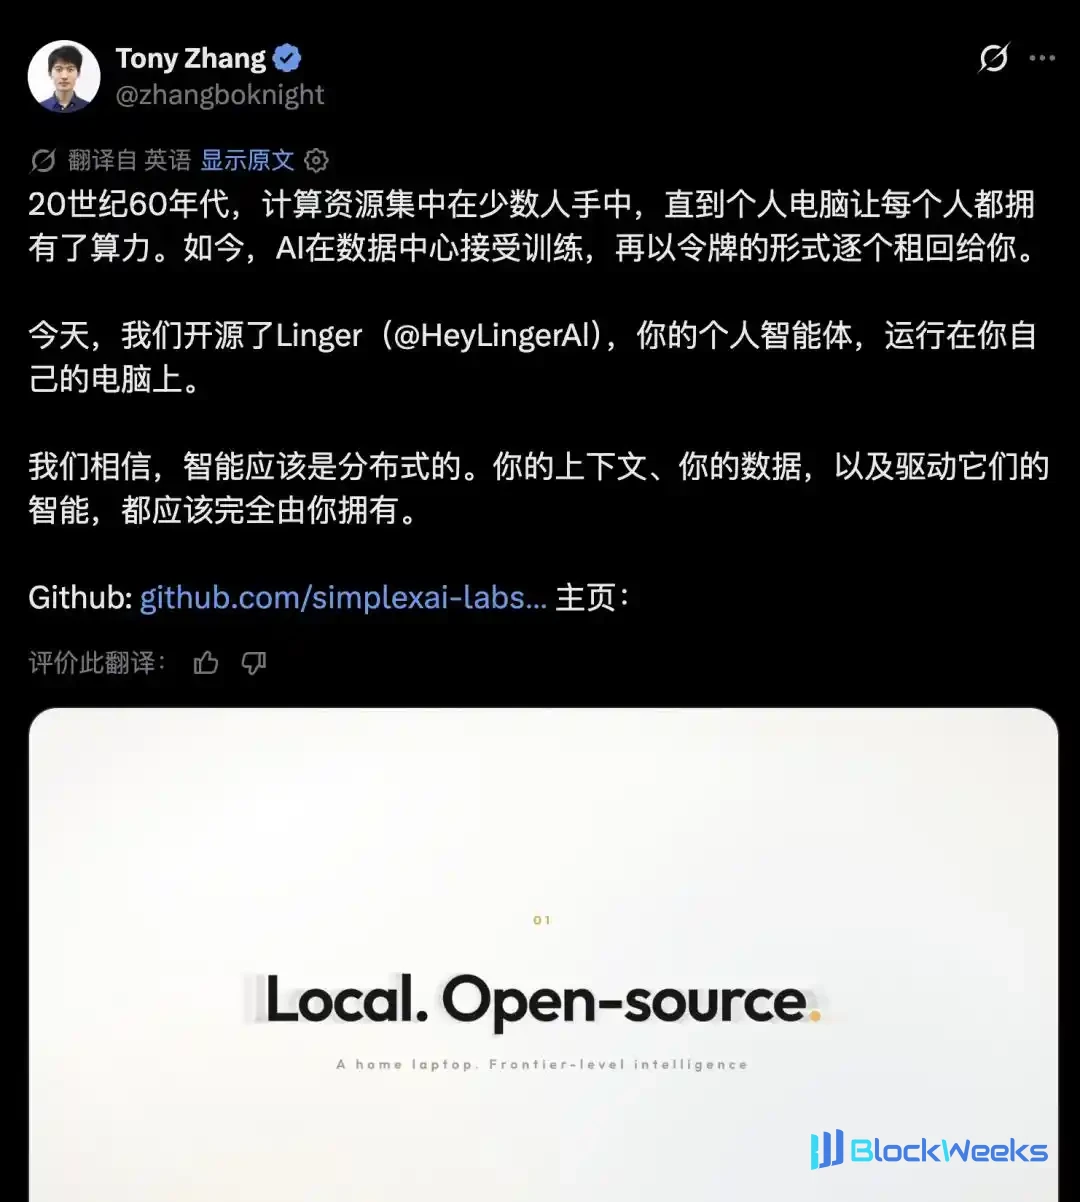
Dans le post d'annonce, Tony Zhang a cité l'histoire de l'essor du PC :
Dans les années 1960, l'informatique était centralisée, jusqu'à ce que le PC mette le pouvoir entre les mains de chacun. Aujourd'hui, l'IA est entraînée dans des centres de données, puis vous est louée sous forme de tokens.
Nous croyons que l'intelligence devrait être distribuée. Votre contexte, vos données et l'intelligence qui les anime devraient vous appartenir entièrement.
Ainsi, aujourd'hui, ils ont open source Linger, un Agent dédié qui vit sur votre ordinateur personnel.
Il perpétue également la belle tradition de la grosse baleine grasse 😭.
Une IA qui « prend l'initiative et peut apprendre d'elle-même »
Le cœur de Linger est un système d'Agent appelé « Un Autre Moi ».
Tout d'abord, c'est un hub de mémoire.
Linger lira localement votre boîte de réception, votre calendrier, vos historiques de discussion et vos réunions, et chaque nuit organisera automatiquement ces informations dans une base de connaissances personnelle (Wiki) que tous les Agents pourront consulter.
Dans le benchmark LoCoMo, qui mesure la capacité de mémoire conversationnelle à long terme, la précision de Linger a atteint 95 %, surpassant plusieurs systèmes d'IA à mémoire renforcée tels que Mem0 et MemOS.

Avec cela, Linger peut travailler de manière proactive et plus efficacement.
Il observera discrètement votre flux d'informations et décidera quand vous rappeler en fonction de l'importance et de l'urgence des événements. S'il reçoit un e-mail d'un client le lundi demandant un devis pour le vendredi, il ne vous dérangera pas immédiatement, mais attendra le mercredi matin pour faire apparaître un rappel.
Mais s'il s'agit d'un changement d'heure de réunion, il vous préviendra immédiatement.

Cet Agent apprend également de vos retours, ce que Linger appelle le « renforcement implicite ».
Par exemple, lorsqu'il vous rappelle qu'une facture est sur le point d'expirer et que vous répondez : « Je l'ai reçue la semaine dernière, vous auriez dû me le dire à ce moment-là. » Le système enregistrera un indice.
Si la prochaine fois une autre facture présente une situation similaire et que vous exprimez à nouveau la même préférence, le système générera automatiquement une règle : « Facture fournisseur → rappeler immédiatement ».

À l'inverse, si vous montrez deux fois de suite un désintérêt pour les « rappels de livraison » (par exemple, en les ignorant directement ou en répondant « ne me le dis pas »), il apprendra aussi à rester silencieux à l'avenir.
Vous pouvez également donner des instructions directes pour tout lui apprendre en une seule fois. Par exemple, dites-lui : « Préviens-moi immédiatement des réponses des clients », ou « Après 21 h, il n'est pas nécessaire de me prévenir tout de suite des changements de réunion. »
Cette interaction et cet apprentissage continus font que l'Agent comprend de mieux en mieux vos habitudes de travail, devenant un véritable assistant personnalisé.
De plus, Linger peut également :
Piloter le bureau et le navigateur.
Comme mentionné au début, Linger peut utiliser directement Chrome et les diverses applications déjà connectées sur votre ordinateur, sans besoin de reconfigurer.
Construire une équipe d'Agents.
C'est le principe du Super Agent que
DeepSeek
a expliqué plus tôt.
Lorsque vous confiez une tâche complexe, Another Me appellera ou créera des Agents aux fonctions différentes pour collaborer au travail.
Et vous n'avez qu'à rester dans cette unique Session avec Linger.
Interaction vocale.
Cela sert principalement les scénarios de bureau.
Linger peut transcrire les réunions en temps réel, et après la réunion, vous pouvez directement interroger l'Agent sur le contenu de la réunion et lui faire assurer le suivi des tâches à faire.
En bref, c'est un Agent Personnel optimisé spécifiquement pour les scénarios de bureau.
Cependant, certains internautes ne comprennent pas tout à fait ce positionnement produit :
Pourquoi ne pas développer sur la base du harness DeepSeek 🤣 Quelle est la différence avec ds-bot ?
En réponse, Tony Zhang a répondu :
Linger se concentre sur l'optimisation conjointe du modèle et du harness : une carte graphique de 12 Go peut exécuter un modèle de 125B localement, sans frais par token, et les données ne quittent jamais la machine locale.
Du point de vue du positionnement produit : le cœur de DS-Bot est la collaboration entre Bots et entre Bots et groupes ; le cœur de Linger est entre une personne et son propre Agent, et entre l'Agent et l'environnement local.

Une carte graphique de 12 Go fait tourner un modèle de 125B
Pour permettre à du matériel grand public de faire tourner des grands modèles à l'échelle de centaines de milliards, la technologie centrale de Linger est un moteur d'inférence MoE appelé PolyStrata.
Son principe peut être compris comme un mécanisme intelligent de stockage hiérarchisé.
Pour un énorme modèle MoE (Mixture of Experts), PolyStrata place les « modules experts » les plus utilisés et les plus actifs dans la mémoire GPU la plus rapide, met les moins utilisés dans la mémoire vive, et place les moins fréquemment utilisés sur le SSD.
Lorsque le modèle doit appeler un certain expert, le système déplace dynamiquement les données entre le GPU, la mémoire vive et le SSD. Ainsi, il n'est pas nécessaire de fourrer l'intégralité du modèle de dizaines ou de centaines de Go dans la mémoire GPU limitée.
L'effet est immédiat.
Selon les données officielles, un modèle Qwen3.8-Flash-Next de 125B paramètres peut atteindre une vitesse de génération de 45,5 tokens/seconde sur un ordinateur équipé d'une RTX 3060 de 12 Go et de 64 Go de mémoire.
Sur une RTX 5090 plus puissante (32 Go), la vitesse grimpe à 179 tokens/seconde.
Pour rendre plus pratique l'utilisation de grands modèles locaux par les utilisateurs, Linger a également créé une fonction « Pilote automatique de modèle ».
Elle détecte automatiquement votre configuration matérielle (GPU, mémoire GPU, mémoire vive), puis recommande et installe pour vous le modèle le plus puissant parmi des combinaisons de 49 modèles de langage, deux moteurs d'inférence, plusieurs schémas de quantification et différentes longueurs de contexte.

Selon le système de notation de SimplexAI, des appareils locaux de différentes configurations peuvent atteindre des capacités comparables aux grands modèles cloud grand public :
Carte graphique de 8 Go + 32 Go de mémoire : score de 35,4, à peu près équivalent à Gemini 2.5 Pro.
Mac 24 Go de mémoire unifiée : score de 51,9, à peu près équivalent à Claude Opus 4.5.
Carte graphique de 12 Go + 32 Go de mémoire : score de 57,3, à peu près équivalent à Claude Opus 4.6.
Cela signifie que votre ordinateur portable de jeu ou votre MacBook disposera d'un cerveau IA véritablement puissant, en veille 24h/24 et 7j/7, sans frais de tokens, et gardant les données entièrement en local.
Le responsable de DeepSeek-VL lance une autre entreprise
Derrière Linger se trouve une équipe dotée d'une solide expérience technique, et le CV de son fondateur Tony Zhang est particulièrement impressionnant.
(Après tout, c'est
DeepSeek
-lié...)

Tony Zhang a obtenu sa licence à l'Université du Zhejiang, a obtenu son doctorat à l'Université des sciences et technologies de Hong Kong en 2019, puis a rejoint Microsoft Research Asia (MSRA), où il s'est longtemps consacré à la recherche en vision par ordinateur et en modèles génératifs. Il est l'auteur de plusieurs projets bien connus tels que VQ-Diffusion et les humains numériques 3D Rodin.
En 2023, il a rejoint
DeepSeek
en tant que scientifique en IA.
Ici, il a non seulement participé à la recherche et au développement du premier modèle de langage
DeepSeek
LLM V1 series, mais a également été chef de projet du grand modèle vision-langage
DeepSeek
-VL. Ce modèle a été très salué pour sa capacité à comprendre les images, les documents et les graphiques dans des scénarios réels.
Après avoir quitté
DeepSeek
, Tony Zhang a rejoint l'Université du Zhejiang en tant que membre du corps enseignant, occupant le poste de chercheur du programme des Cent Talents et de directeur de thèse, et a fondé Simplex AI.
Linger est le dernier travail de Simplex AI.

Et en tant que cœur technique de Linger, ce moteur d'inférence conçu spécifiquement pour le déploiement local ?
Selon Tony Zhang, il a été construit par un génie de 18 ans dans l'équipe.
18 ans ? Tout juste diplômé du lycée ?
Cet article provient du compte public WeChat « Quantum Bit », auteur : Jay