Reunidos, somos un fuego; dispersos, somos estrellas en el cielo.
Justo ahora, el autor de
DeepSeek
V1 y el líder del proyecto de
DeepSeek
-VL, Tony Zhang (Zhang Bo), ha anunciado oficialmente su nuevo proyecto de emprendimiento: Linger.
La dirección es exactamente lo más candente en este momento: el Agente Personal.
El enfoque también es bastante interesante. Mientras sus pares están todos haciendo aplicaciones, ellos eligieron primero la computadora.
Esto significa que Linger puede operar las páginas web, la bandeja de entrada y el calendario que ya están en tu computadora, sin la molestia de un montón de credenciales de inicio de sesión.
Cuando se atasca en algún lugar, también puedes tomar el control directamente.
Otro punto: como capa intermedia, Linger admite la conexión con diversos modelos de terceros.
Y se ha optimizado específicamente para LLM locales.
En concreto, una sola tarjeta gráfica RTX 3060 con 12 GB de VRAM puede ejecutar un Qwen3.8-Flash-Next de 125B parámetros, a una velocidad de generación de 45,5 tokens/segundo.
Ah, cierto, también hay algo bastante importante—
Este sistema es de código abierto...
¿Y por qué?
En la publicación del anuncio, Tony Zhang citó la historia del auge de la PC:
En la década de 1960, la computación estaba centralizada, hasta que la PC puso el poder en manos de todos. Hoy, la IA se entrena en centros de datos y luego se te alquila en forma de tokens.
Creemos que la inteligencia debe estar distribuida. Tu contexto, tus datos y la inteligencia que los impulsa deben ser completamente tuyos.
Así que hoy, han abierto el código de Linger, un Agente dedicado que vive en tu computadora personal.
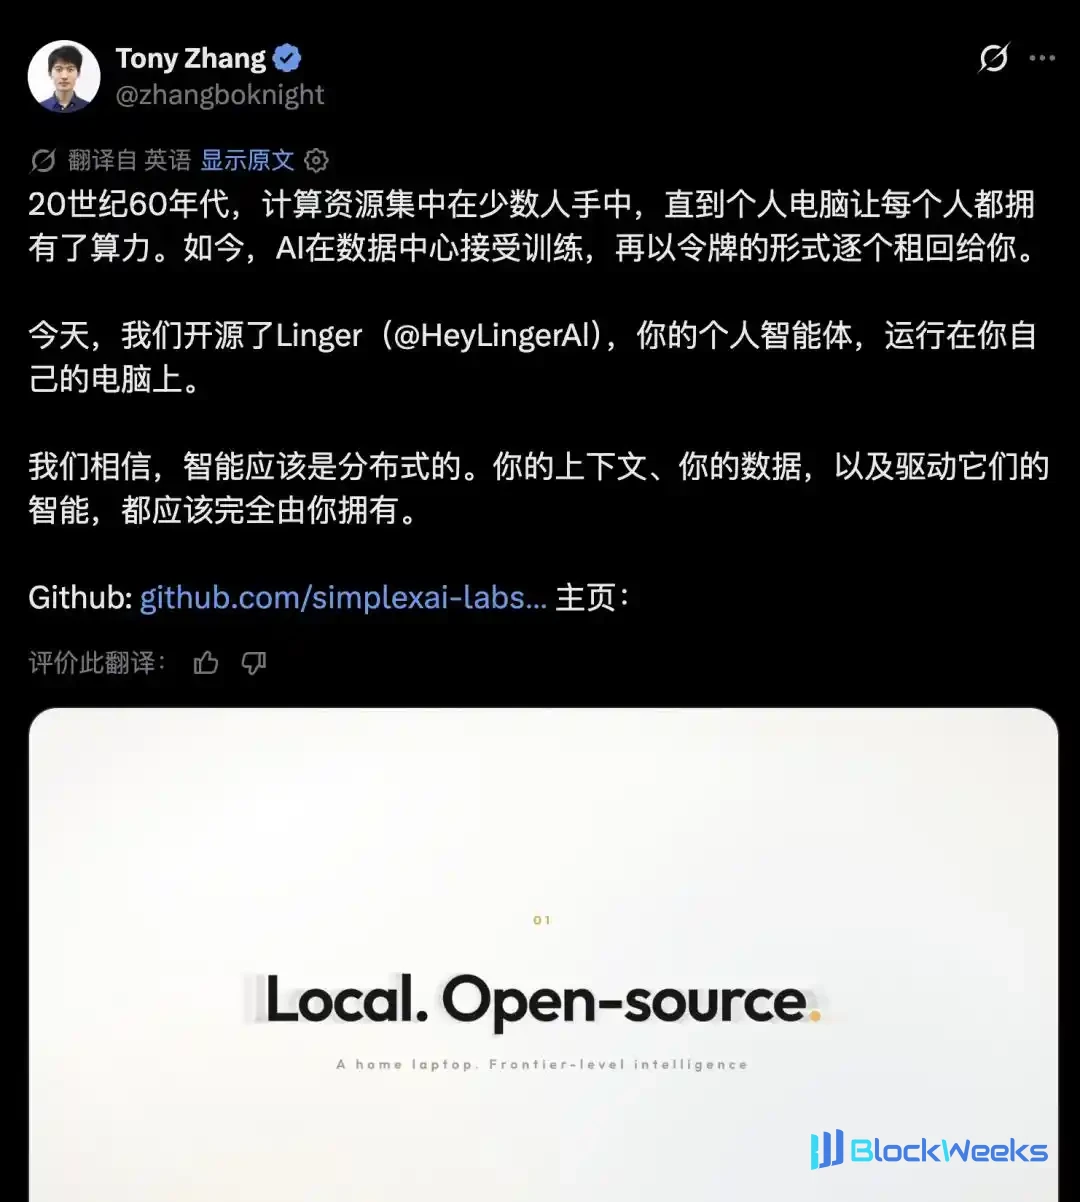
También continúa la fina tradición de la gran ballena gorda 😭.
Una IA que "toma la iniciativa y puede autoaprender"
El núcleo de Linger es un sistema de Agente llamado "Otro Yo".
En primer lugar, es un centro de memoria.
Linger leerá localmente tu bandeja de entrada, calendario, registros de chat y reuniones, y cada noche organizará automáticamente esta información en una base de conocimiento personal (Wiki) para que todos los Agentes la consulten.
En el benchmark LoCoMo, que mide la capacidad de memoria conversacional a largo plazo, la precisión de Linger alcanzó el 95%, superando a múltiples sistemas de IA con memoria mejorada como Mem0 y MemOS.

Con esto, Linger puede trabajar de forma proactiva mucho mejor.
Observará silenciosamente tu flujo de información y decidirá cuándo recordarte algo según la importancia y urgencia de los eventos. Si recibe un correo de un cliente el lunes solicitando una cotización para el viernes, no te molestará de inmediato, sino que esperará hasta la mañana del miércoles para mostrarte un recordatorio.
Pero si se trata de un cambio de hora de una reunión, te lo notificará de inmediato.

Este Agent también aprende de tus comentarios, lo que Linger llama "refuerzo implícito".
Por ejemplo, cuando te recuerda que una factura está a punto de vencer, y tú respondes: "La recibí la semana pasada, deberías habérmelo dicho entonces". El sistema registrará una pista.
Si la próxima vez otra factura tiene una situación similar y vuelves a expresar la misma preferencia, el sistema generará automáticamente una regla: "Factura de proveedor → recordar de inmediato".

Por el contrario, si muestras desinterés en los "recordatorios de entrega" dos veces seguidas (por ejemplo, ignorándolos directamente o respondiendo "no me lo digas"), también aprenderá a permanecer en silencio en el futuro.
También puedes darle instrucciones directas para enseñarle todo de una vez. Por ejemplo, dile: "Notifícame de inmediato las respuestas de los clientes", o "Después de las 9 p. m., no hace falta que me avises de inmediato sobre cambios de reuniones".
Esta interacción y aprendizaje continuos hacen que el Agent comprenda cada vez mejor tus hábitos de trabajo, convirtiéndose en un asistente verdaderamente personalizado.
Además, Linger también puede:
Operar el escritorio y el navegador.
Como se mencionó al principio, Linger puede usar directamente Chrome y las diversas aplicaciones que ya tienes iniciadas en tu computadora, sin necesidad de reconfigurar nada.
Construir un equipo de Agents.
Este es el principio de Super Agent que
DeepSeek
explicó anteriormente.
Cuando asignas una tarea compleja, Another Me llamará o creará Agents con diferentes funciones para colaborar en el trabajo.
Y tú solo necesitas permanecer en esta única Sesión con Linger.
Interacción por voz.
Esto sirve principalmente para escenarios de oficina.
Linger puede transcribir reuniones en tiempo real, y después de la reunión puedes preguntarle directamente al Agent sobre el contenido de la reunión y hacer que dé seguimiento a las tareas pendientes.
En resumen, es un Personal Agent optimizado específicamente para escenarios de oficina.
Sin embargo, algunos usuarios de internet no entienden del todo este posicionamiento del producto:
¿Por qué no desarrollar basándose en el harness de DeepSeek 🤣? ¿Cuál es la diferencia con ds-bot?
En respuesta, Tony Zhang contestó:
El enfoque de Linger está en optimizar el modelo y el harness en conjunto: una tarjeta gráfica de 12 GB puede ejecutar un modelo de 125B localmente, sin tarifas por token, y los datos nunca salen de la máquina local.
Desde la perspectiva del posicionamiento del producto: el núcleo de DS-Bot es la colaboración entre Bots y Bots, y entre Bots y grupos; el núcleo de Linger es entre una persona y su propio Agente, y entre el Agente y el entorno local.

Tarjeta gráfica de 12 GB, ejecuta un modelo de 125B
Para permitir que el hardware de consumo ejecute modelos grandes a escala de cientos de miles de millones, la tecnología central de Linger es un motor de inferencia MoE llamado PolyStrata.
Su principio puede entenderse como un mecanismo inteligente de almacenamiento por niveles.
Para un enorme modelo MoE (Mezcla de Expertos), PolyStrata coloca los "módulos de expertos" más utilizados y más activos en la memoria de GPU más rápida, coloca los menos utilizados en la memoria RAM y sitúa los de uso menos frecuente en la unidad de estado sólido SSD.
Cuando el modelo necesita llamar a un determinado experto, el sistema mueve dinámicamente datos entre la GPU, la memoria RAM y el SSD. De esta manera, no es necesario meter todo el modelo de decenas o cientos de GB en la limitada memoria de GPU.
El efecto es inmediato.
Según datos oficiales, un modelo Qwen3.8-Flash-Next de 125B parámetros puede alcanzar una velocidad de generación de 45,5 tokens/segundo en un ordenador equipado con una RTX 3060 de 12 GB y 64 GB de memoria RAM.
En la más potente RTX 5090 (32 GB), la velocidad se dispara hasta los 179 tokens/segundo.
Para que los usuarios puedan utilizar los modelos grandes locales de forma más cómoda, Linger también ha creado una función de "piloto automático de modelos".
Detecta automáticamente la configuración de tu hardware (GPU, memoria de GPU, memoria RAM) y luego te recomienda e instala el modelo más potente para ti entre combinaciones de 49 modelos de lenguaje, dos motores de inferencia, múltiples esquemas de cuantización y diferentes longitudes de contexto.

Según el sistema de puntuación de SimplexAI, los dispositivos locales con diferentes configuraciones pueden alcanzar capacidades comparables a los principales modelos grandes en la nube:
Tarjeta gráfica de 8 GB + 32 GB de memoria RAM: puntuación 35,4, aproximadamente equivalente a Gemini 2.5 Pro.
Mac con 24 GB de memoria unificada: puntuación 51,9, aproximadamente equivalente a Claude Opus 4.5.
Tarjeta gráfica de 12 GB + 32 GB de memoria RAM: puntuación 57,3, aproximadamente equivalente a Claude Opus 4.6.
Esto significa que tu portátil gaming o MacBook tendrá un cerebro de IA verdaderamente potente que está en espera las 24 horas, no cobra tarifas por token y mantiene los datos completamente locales.
El líder de DeepSeek-VL inicia otro negocio
Detrás de Linger hay un equipo con una profunda base técnica, y el currículum de su fundador Tony Zhang es especialmente impresionante.
(Después de todo, está relacionado con
DeepSeek
...)

Tony Zhang obtuvo su licenciatura en la Universidad de Zhejiang, obtuvo su doctorado en la Universidad de Ciencia y Tecnología de Hong Kong en 2019, y posteriormente se unió a Microsoft Research Asia (MSRA), donde ha estado involucrado durante mucho tiempo en la investigación de visión por computadora y modelos generativos. Es autor de varios proyectos conocidos como VQ-Diffusion y los humanos digitales 3D Rodin.
En 2023, se unió a
DeepSeek
como científico de IA.
Aquí, no solo participó en la investigación y el desarrollo del modelo de lenguaje temprano
DeepSeek
LLM V1 series, sino que también se desempeñó como líder del proyecto del gran modelo de visión-lenguaje
DeepSeek
-VL. Este modelo ha sido muy elogiado por su capacidad para comprender imágenes, documentos y gráficos en escenarios del mundo real.
Después de dejar
DeepSeek
, Tony Zhang se unió a la Universidad de Zhejiang como miembro del profesorado, desempeñándose como investigador del Programa de Cien Talentos y supervisor de doctorado, y fundó Simplex AI.
Linger es el trabajo más reciente de Simplex AI.

¿Y como núcleo técnico de Linger, ese motor de inferencia construido específicamente para el despliegue local?
Según Tony Zhang, fue construido por un genio de 18 años en el equipo.
¿18 años? ¿Acaba de graduarse de la escuela secundaria?
Este artículo es de la cuenta pública de WeChat "Quantum Bit", autor: Jay